Akademia NIS2/KSC2 od sekuraka. 19 października start drugiej edycji!
Konferencja Mega Sekurak Hacking Party w Krakowie – 26-27 października!
Akademia NIS2/KSC2 od sekuraka. 19 października start drugiej edycji!
Konferencja Mega Sekurak Hacking Party w Krakowie – 26-27 października!
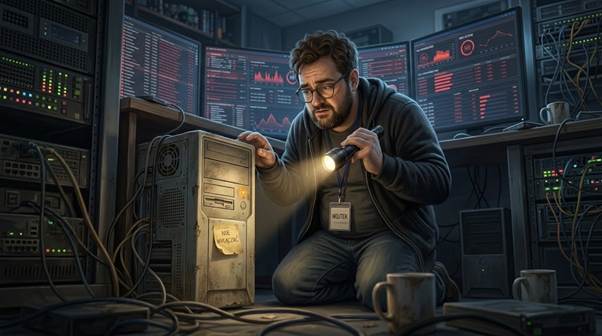
Serwer, którego nikt nie dokumentował, ale wszyscy bali się wyłączyć
Pełna lista odcinków: tutaj
Chcesz używać AI do zbudowania pierwszego runbooka dla systemu, którego dokumentacji nikt nie prowadził? Właśnie takie przypadki analizujemy podczas szkolenia AI w pracy admina. Case studies, narzędzia, praktyka: legacy serwery, rozproszoną wiedzę w ticketach i głowach ludzi, brak właściciela – czyli codzienność admina. Mamy za sobą już dwie sesje, szkolenie wystartowało 21 września, ale cały czas można dołączyć 😉 Szczegóły i zapisy z rabatem dla czytelników sekuraka – tutaj.
W każdym środowisku jest przynajmniej jeden taki serwer. Czasem to VM-ka postawiona pięć lat temu „na chwilę”, czasem stara maszyna fizyczna. Czasem ma nazwę, która nic już nie znaczy, bo projekt zmienił nazwę trzy razy. Czasem w panelu wirtualizacji opis brzmi po prostu: „nie wyłączać”.
I to jest cała dokumentacja.
Na przykład srv-old-app-02. System trochę aktualny, trochę nie. Uptime liczony w setkach dni. Kilka otwartych portów. Dziwny nginx. Jakiś proces Javy. Crontaby z roota. Skrypty w /opt. Logi w katalogu, który nie pasuje do żadnego standardu.
Ktoś mówi, że kiedyś po restarcie „coś się zepsuło”. Ktoś inny pamięta, że serwer był chyba powiązany z fakturami. Trzecia osoba mówi, że „Marek będzie wiedział”. Marek oczywiście jest na urlopie.
To jest moment, w którym AI wydaje się idealnym narzędziem. Można zebrać zrzut informacji z systemu, wkleić go do modelu i zapytać: „co to za serwer?”. Model odpowie. Bardzo możliwe, że odpowie składnie, logicznie i z dużą pewnością.
I właśnie tę pewność trzeba potraktować ostrożnie.
Legacy serwer to zbiór faktów, hipotez i brakujących danych, a nie zagadka logiczna, którą rozwiąże jedno dobrze sformułowane pytanie do modelu.
Jeśli model napisze: „serwer obsługuje wewnętrzną aplikację raportową”, może mieć rację. Może też zgadywać na podstawie nazwy procesu, ścieżki albo fragmentu loga. W dokumentacji operacyjnej różnica między faktem a hipotezą jest krytyczna.
Fakt można wykorzystać do decyzji. Hipotezę trzeba sprawdzić.
Dlatego pracę zaczynamy od pakietu diagnostycznego, a nie od wielkiego promptu do modelu.
Zbieramy rzeczy nudne, ale konkretne:
Chodzi o zebranie materiału dowodowego, a nie o bezmyślne wrzucenie wszystkiego do modelu.
Następnie selekcjonujemy informacje.
Fakty:
Hipotezy:
Brakujące dane:
Dopiero z tak przygotowanego materiału AI może zrobić użyteczny pierwszy szkic runbooka.
Polecenie dla modelu brzmi inaczej niż proste „powiedz prawdę o serwerze”:
Przygotuj pierwszy runbook operacyjny. Oddziel fakty od hipotez, wypisz brakujące dane i pytania do właścicieli. Nie zakładaj, że można restartować system.
Dobry pierwszy runbook ma być użyteczny o drugiej w nocy, a nie piękną dokumentacją architektury.
Powinien zawierać:
Ta ostatnia sekcja jest jedną z najważniejszych. Brak wiedzy też stanowi informację operacyjną.
Wiele organizacji ma ten problem nie z braku wiedzy, lecz dlatego, że wiedza jest rozproszona i nieoznaczona: trochę w ticketach, trochę w komunikatorze, trochę w nazwach katalogów i trochę w głowach ludzi.
AI może pomóc zebrać te okruchy i ułożyć je w pierwszy szkic. Nie może jednak potwierdzić faktów, których nie zawiera materiał wejściowy.
Największą wartością pierwszego runbooka nie jest kompletność, lecz obniżenie lęku przed systemem.
Zamiast „nie dotykać, bo nie wiemy” mamy:
Wiemy tyle. Tego nie wiemy. To sprawdzamy. Restart wykonamy dopiero po spełnieniu tych warunków.
To pozwala zaplanować przegląd, backup, test odtworzenia, rozmowę z biznesem, migrację albo przynajmniej sensowną obserwację.
AI może pomóc przygotować konkretne pytania:
W ten sposób strach przed systemem zamienia się w listę sprawdzalnych pytań. A taka lista prowadzi do sensownego utrzymania procesu.
AI jest dobra w robieniu pierwszego szkicu z chaosu, nie w zgadywaniu prawdy.
Jeśli masz serwer, którego wszyscy boją się wyłączyć, zacznij od faktów, a nie od restartu czy jednego promptu do modelu. Zbierz pakiet diagnostyczny, oddziel fakty od hipotez, przygotuj pierwszy runbook i daj go człowiekowi (adminowi!) do weryfikacji.
Legacy system oswaja się przez małe, nudne i sprawdzalne kroki. W takich krokach AI może być naprawdę przydatna.
~Maciej Szymczak
Arrykuł zapomina o jednym, ważnym szczególe. Uzyskaniu dostępu do systemu operacyjnego. Przy odrobinie szczęścia programista zostawi sobie webshell w katalogu z aplikacją. Może bez sudo, ale zawsze jakiś początek. Przy jeszcze większym szczęściu to VM-ka właśnie, więc się sklonuje, wyłączy interfejsy sieciowe w nadzorcy i włamie. A jeżeli to stary pecet z freebsd, który po ostrożnym otwarciu obudowy ujawni dwa dyski (jakiś programowy raid na stówę), kilka zdechłych pająków i kartkę z niedziałającym hasłem, czeka nas nocka z dd i próbą ponownego uruchomienia tego komputera, zanim wszyscy wrócą do pracy.
Nie zapomnij, że jeżeli to stary PC z uptime rzędu kilkuset dni, to po wyłączeniu go z prądu może już się nie podnieść. Kondensatory na płycie czy w zasilaczu mogą być na wykończeniu. Puki działa, to działa, a jak zabraknie prądu to może umrzeć. Na rano może nie działać. A jeżeli to jakiś Sun lub Silicon Power a nie PC? O zgrozo 🤯😱
Kiedyś miałem IBM AS/400.
Ekstra punkty, jeśli to w przemyśle a w sprzęcie-zombi jest stacja dyskietek 5,25″ i coś w niej siedzi. I czasem burczy.
być może nawet ważniejsze od zbadania nieznajomej maszyny jest przeszukanie wszystkich konfiguracji, a może nawet i repozytoriów na innych maszynach pod kątem odniesień do niej
Oto przykład realnych problemów ze świata OT
Tylko jedno takie urządzanie i jeszcze macie do niego hasło admina – to luksus którego wielu w świece OT nie ma.
A prawdzie przypadki ze świata OT to kiedy macie zestaw takich 3 urządzeń powiązanych ze sobą z wieloma komponentami programowymi i po latach nikt nie zna haseł, dokumentacji nie ma podobnie jak firm które je dostarczyły.
Wtedy po latach wybawieniem może się okazać domyślne hasło którego wbrew wszelkim audytorom cybersecurity integrator nie zmienił.
Ciekawe na czym przetestujecie odtworzenie backupu – kiedy takie urządzenia są już niedostępne od wielu lat.
A za chwile radośni twórcy zasad CRA doprowadza do patologicznej sytuacji, że już nikt nie będzie chciał tam cokolwiek poprawić bo nagle stanie się producentem produktu cyfrowego.